
أنجز المزيد بكل واط
احصل على المزيد من القدرة الحوسبية للذكاء الاصطناعي لكل واط مع عناقيد عالية الكثافة مبردة بالسائل. توفر بيئات النشر المخصصة بالكامل (Single-Tenant) مراقبة كاملة وهيكلية هندسية مطورة بالتعاون مع الخبراء لتحقيق أقصى أداء وموثوقية في بيئة التشغيل الفعلي.
- سحابة ذكاء اصطناعي مُصممة لأغراض متخصصة
-
بناء ونشر أحدث تطبيقات الذكاء الاصطناعي التوليدي باستخدام منصة رائدة في الصناعة.
-
أمان على مستوى المؤسسات: عناقيد أحادية المستأجر (Single-Tenant Clusters) معزولة فيزيائياً مع تخزين مشفر، وأقفاص أمان، وصلاحيات وصول دقيقة ومحددة.أمان على مستوى المؤسسات/01
-
مُخصصة لأعباء عملك: عناقيد مطورة بشكل مشترك لتناسب عبء عمل الذكاء الاصطناعي الخاص بك لمجموعة واسعة من النماذج والأطر ومتطلبات الأداء.مُخصصة لأعباء عملك/02
-
موثوقية عالية: اختبارات الجهد والتحمل الشاملة قبل التسليم، بالإضافة إلى الأنظمة الاحتياطية المدمجة لضمان استمرارية الخدمة العالية (High Availability).موثوقية عالية/03
-
قابلية المراقبة: مراقبة الطاقة والتبريد والشبكة والتخزين والحوسبة باستخدام حزمة أدوات المراقبة من نولدج بريدج للمراقبة (Prometheus، وOpenTelemetry، وGrafana) أو نظامك الخاص.قابلية المراقبة/04
-
دعم خبير على مدار الساعة: مهندسون مخصصون لمشروعك، وتحسين في الوقت الفعلي، ومسارات تصعيد واضحة لأعطال الأنظمة الحرجة للغاية (Mission-critical).دعم خبير على مدار الساعة/05
-
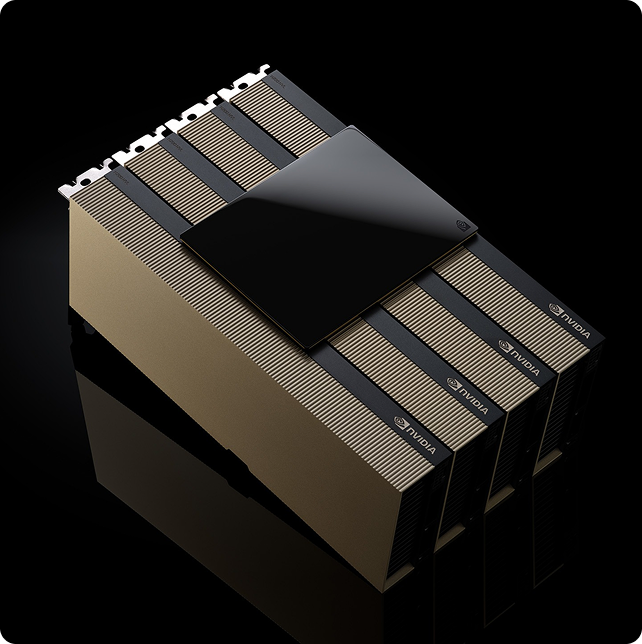
NVIDIA VR200 NVL72
نظام متكامل على مستوى الرف مُحسَّن لتطبيقات وكلاء الذكاء الاصطناعي.
72 × وحدة معالجة رسوميات روبين / 36 × وحدة معالجة مركزية فيرا لكل رف خوادم.
~75 تيرابايت من الذاكرة الإجمالية (20.7 تيرابايت HBM4 + 54 تيرابايت LPDDR5X) / 260 تيرابايت/ثانية من عرض النطاق الترددي NVLink.
-
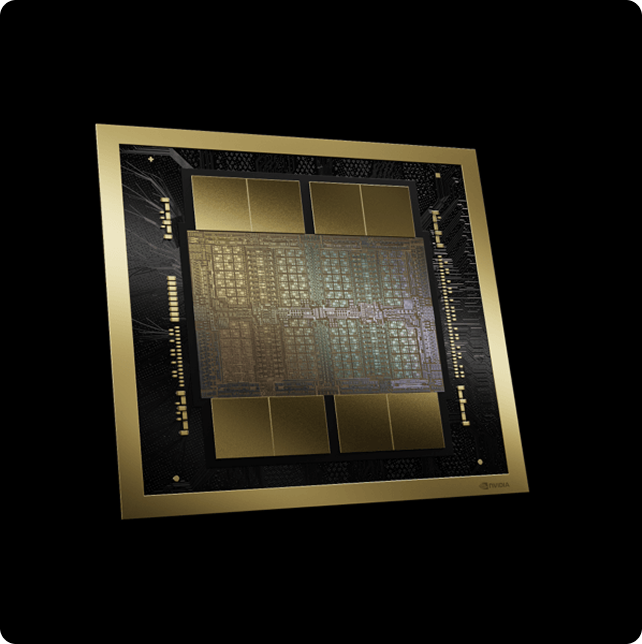
NVIDIA GB300 NVL72
نظام متكامل على مستوى الرف مُحسّن لاستدلال الذكاء الاصطناعي.
كل رف مجهز بـ 72 × Blackwell Ultra GPU / 36 × Grace CPU.
37 تيرابايت ذاكرة حوسبة فائقة السرعة / 130 تيرابايت/ثانية عرض النطاق الترددي عبر خطوط ترابط NVLink Switch.
-
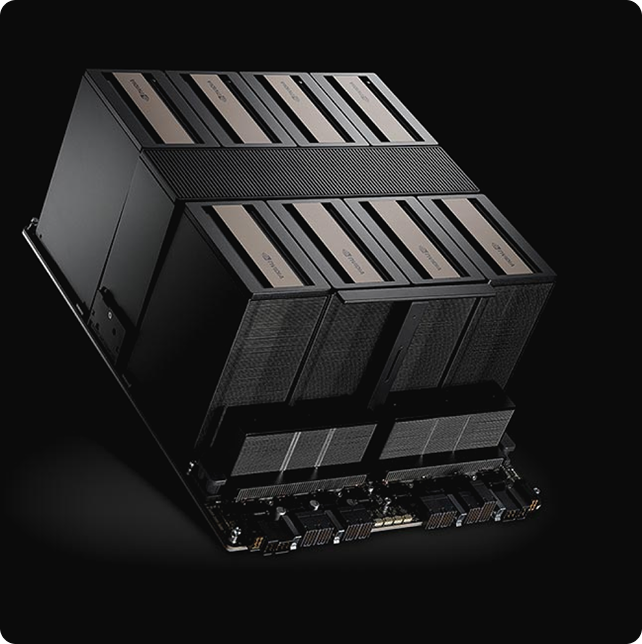
NVIDIA HGX B300
أعلى مستويات الأداء القصوى لكل واط أثناء التدريب.
72 بيتافلوبس بدقة FP8 للتدريب / 144 بيتافلوبس بدقة FP4 للاستدلال.
2.1 تيرابايت من ذاكرة HBM3e / NVIDIA ConnectX-8 SuperNIC.
-
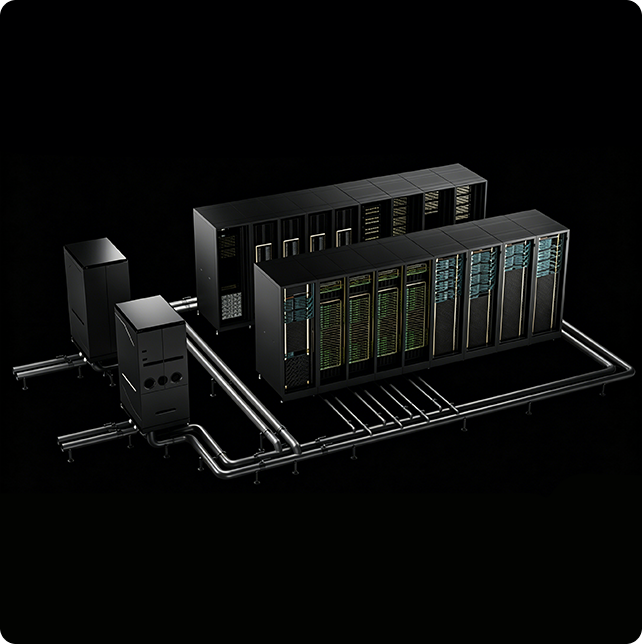
NVIDIA GB200 NVL72 / HGX B200
تحسن الأداء بمقدار 1.9 ضعف مقارنة بجهاز H100 GPU مع معالجات Tensor Cores.
كل خادم يمتلك ذاكرة GPU إجمالية قدرها 1,128 جيجابايت، لمعالجة البيانات المطلوبة لأعباء عمل الذكاء الاصطناعي التوليدي.
اعتماد شبكة NVIDIA Quantum-2 InfiniBand بسرعة 3200Gbps لتحقيق اتصال ذو زمن استجابة منخفض للغاية بين وحدات GPU.
-
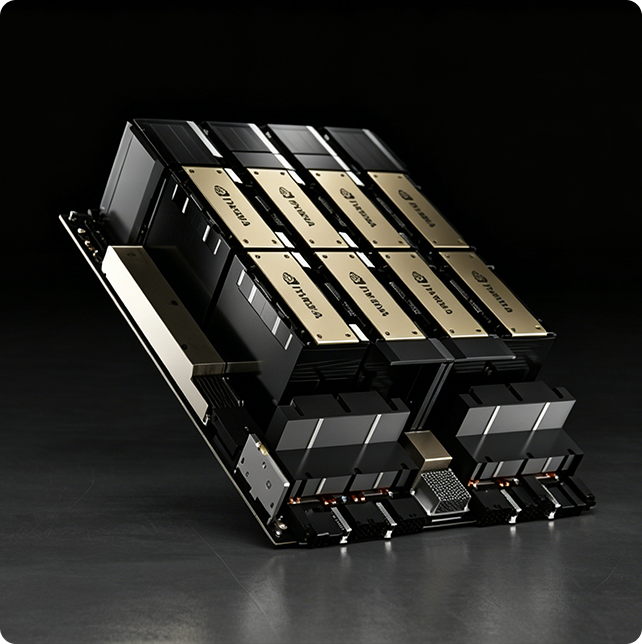
NVIDIA H200 Tensor Core GPU
- مقارنةً بـ NVIDIA A100 Tensor Core GPU، تحسن أداء التدريب إلى ما يصل إلى 4 أضعاف.
-
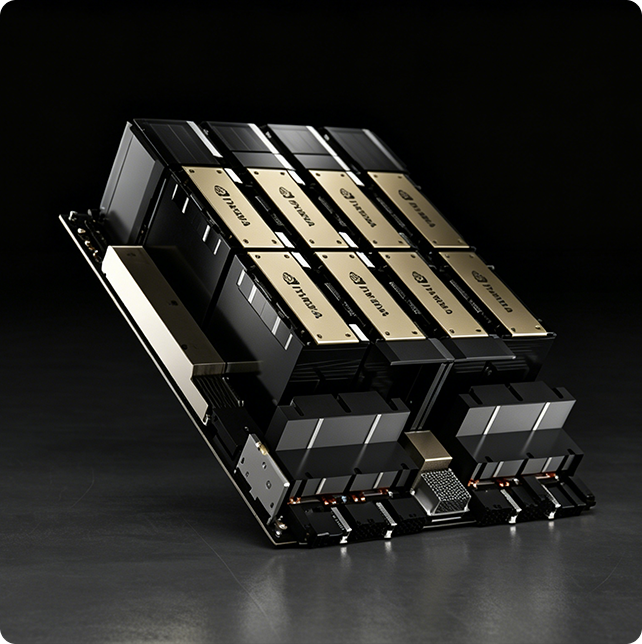
NVIDIA H100 Tensor Core GPU
- مقارنةً بجهاز NVIDIA A100 Tensor Core GPU، تحسن أداء التدريب بما يصل إلى 4 أضعاف.
-
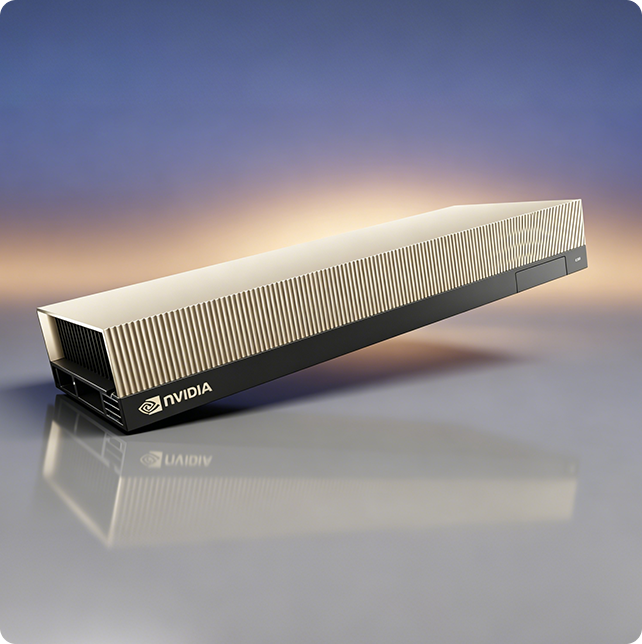
NVIDIA HGX A100
- يتميز بأداء مزدوج مقارنةً بنسخة A40 الأساسية، مع قدرة 733 تي إف لو، ومزود بوظيفة تفريغ NVIDIA Bluefield-3 DPU.
-
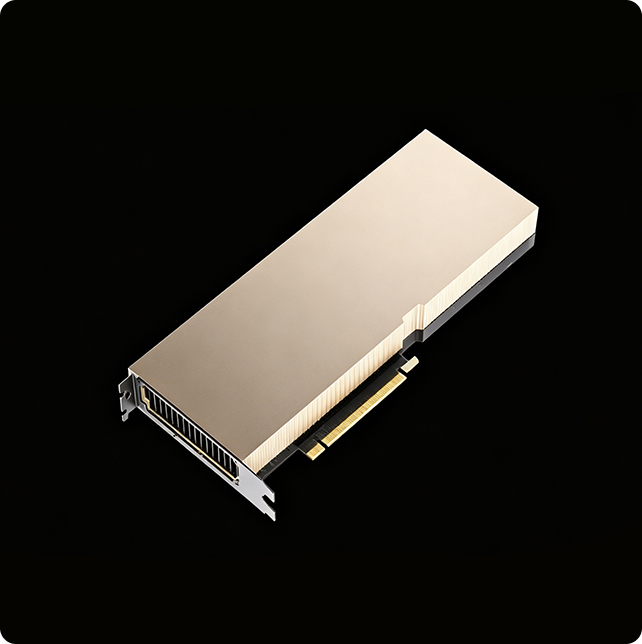
NVIDIA PCIE A100
- مقارنةً بجهاز NVIDIA A100 Tensor Core GPU، تحسن أداء التدريب بنسبة تصل إلى 4 أضعاف.
-
NVIDIA L40, L40S
- يتميز بأداء مزدوج مقارنةً بنسخة A40 الأساسية، مع قدرة 733 تيرافلوبس (TFLOPS) بخاصية تفريغ الأحمال التشغيلية عن المعالجة بـ NVIDIA Bluefield-3 DPU.
يتم تجهيز كل خادم بذاكرة GPU إجمالية قدرها 1,128 جيجابايت لمعالجة البيانات اللازمة لأحمال عمل الذكاء الاصطناعي التوليدي.
يمكنك الوصول إلى إعدادات NVIDIA L40 وضبط تكوينها وتخصيصها وفقًا لاحتياجاتك الحسابية الخاصة للحصول على مرونة محسنة.
- يتميز بأداء مزدوج مقارنةً بنسخة A40 الأساسية، مع قدرة 733 تيرافلوبس (TFLOPS) بخاصية تفريغ الأحمال التشغيلية عن المعالجة بـ NVIDIA Bluefield-3 DPU.
-
NVIDIA A40
- مقارنةً بـ NVIDIA A100 Tensor Core GPU، تحسن أداء التدريب إلى ما يصل إلى 4 أضعاف.