

مصممة خصيصًا لأعباء عمل الذكاء الاصطناعي
الانتقال من النموذج الأولي إلى مرحلة التشغيل الفعلي / جاهزة للتشغيل الفعلي
عناقيد NVIDIA HGX B200 أو H100 جاهزة للإنتاج من 16 إلى 2000+ وحدة معالجة رسوميات من NVIDIA. مُحسَّنة بالكامل للتدريب على الذكاء الاصطناعي، والضبط الدقيق، والاستدلال على نطاق واسع.
- ابدأ رحلتك في عالم الذكاء الاصطناعي
-
عناقيد متخصصة متصلة بـ InfiniBand مصممة خصيصًا لأعباء الذكاء الاصطناعي.
-
أعلى مستويات الأداء مع NVIDIA: بدمج عقد NVIDIA HGX B200 SXM6 وشبكة Quantum-2 InfiniBand مع تقنية تسريع SHARP، توفر هذه العناقيد أداءً أعلى في معالجة أحمال العمل الموزعة على نطاق واسع.أعلى مستويات الأداء مع NVIDIA/01
-
النهج الأمني القائم على الثقة الصفرية: على البنية التحتية للذكاء الاصطناعي المعتمدة بشهادة SOC 2 Type II، يمكنك تشغيل أعباء العمل ذات المتطلبات الأمنية الصارمة بثقة.النهج الأمني القائم على الثقة الصفرية/02
-
إدارة وجدولة الموارد المدارة بالكامل: إدارة Kubernetes أو Slurm بالكامل، متوافقة مع أنظمة التخزين الكائني S3.إدارة وجدولة الموارد المدارة بالكامل/03
-
الوصول السريع: توفير الخدمات ذاتياً مباشرة من خلال لوحة تحكم "جسر المعرفة" السحابية. ويمكن توقيع عقود قصيرة وطويلة الأجل مع توفير بيئة لإثبات المفهوم (POC).الوصول السريع/04
-
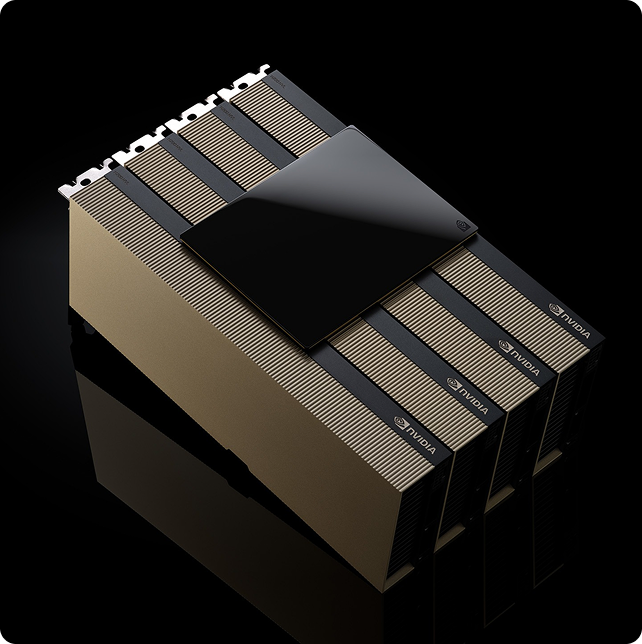
NVIDIA VR200 NVL72
نظام متكامل على مستوى الرف مُحسَّن لتطبيقات وكلاء الذكاء الاصطناعي.
72 × وحدة معالجة رسوميات روبين / 36 × وحدة معالجة مركزية فيرا لكل رف خوادم.
~75 تيرابايت من الذاكرة الإجمالية (20.7 تيرابايت HBM4 + 54 تيرابايت LPDDR5X) / 260 تيرابايت/ثانية من عرض النطاق الترددي NVLink.
-
NVIDIA GB300 NVL72
نظام متكامل على مستوى الرف مُحسّن لاستدلال الذكاء الاصطناعي.
كل رف مجهز بـ 72 × Blackwell Ultra GPU / 36 × Grace CPU.
37 تيرابايت ذاكرة حوسبة فائقة السرعة / 130 تيرابايت/ثانية عرض النطاق الترددي عبر خطوط ترابط NVLink Switch.
-
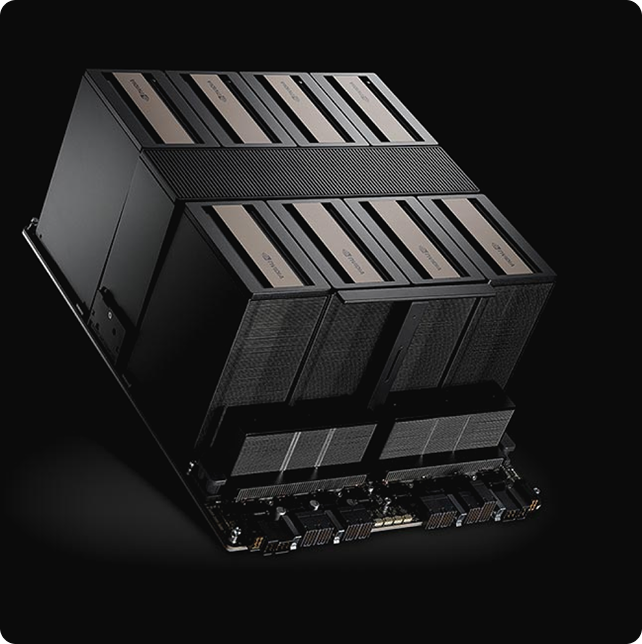
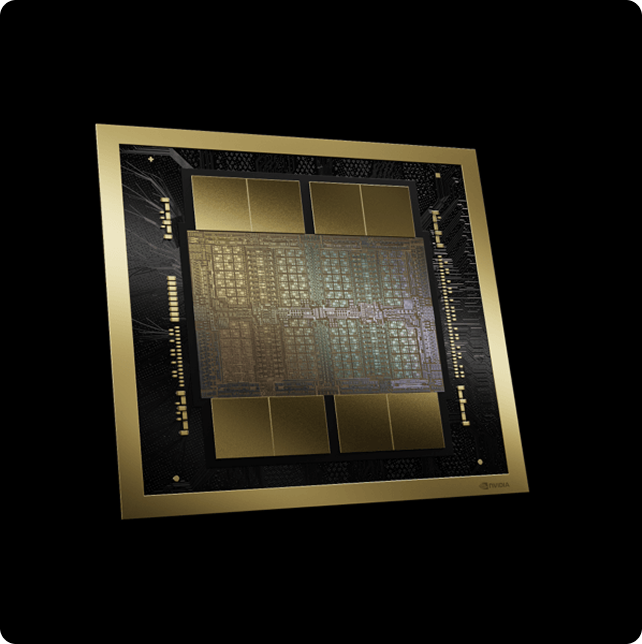
NVIDIA HGX B300
أعلى مستويات الأداء القصوى لكل واط أثناء التدريب.
72 بيتافلوبس بدقة FP8 للتدريب / 144 بيتافلوبس بدقة FP4 للاستدلال.
2.1 تيرابايت من ذاكرة HBM3e / NVIDIA ConnectX-8 SuperNIC.